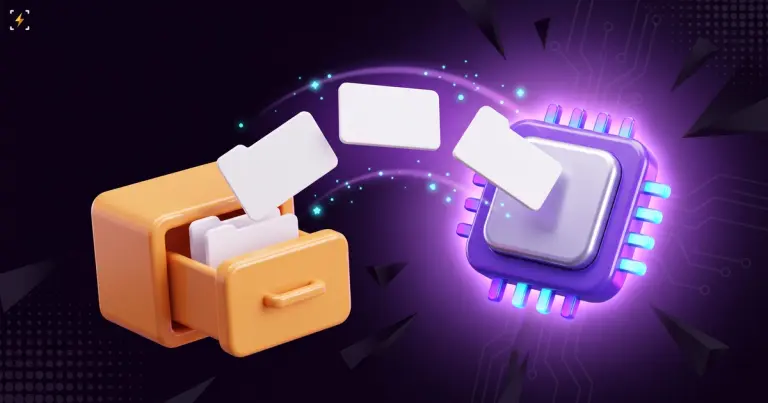
RAG и дообучение в ИИ: два способа научить модель вашим документам
Компании, которая хочет, чтобы чат-бот отвечал по её договорам, инструкциям или обращениям в поддержку, есть два основных пути.
RAG находит нужные страницы до того, как модель ответит. Дообучение переобучает саму модель на ваших примерах. Их часто путают, хотя они решают разные задачи.
Как работает RAG
RAG расшифровывается как retrieval-augmented generation, генерация с опорой на поиск. Документы режут на фрагменты и складывают в векторную базу данных в виде эмбеддингов, числовых отпечатков смысла.
Когда пользователь задаёт вопрос, система находит самые близкие фрагменты, вставляет их в промпт и просит модель отвечать по ним.
Метод описан в статье 2020 года исследователей из Facebook AI Research, Университетского колледжа Лондона и Нью-Йоркского университета. Они назвали две проблемы, которые он должен был решить.
“Указывать, откуда взяты их решения, и обновлять их знания о мире по-прежнему остаётся открытой исследовательской задачей.”
— Патрик Льюис и соавторы, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
Источник цитаты: arXiv, май 2020.
Именно с этим RAG справляется лучше всего. Можно показать, с какой страницы взят ответ, и обновить знания заменой документа, не трогая модель. Но поиск может промахнуться: если система достала не тот фрагмент, модель уверенно ответит по чужой странице.
Anthropic в сентябре 2024 года проверила одно исправление: перед индексацией к каждому фрагменту добавляли короткое описание документа, из которого он взят. Метод называется Contextual Retrieval, и, по данным компании, он сократил промахи поиска на 49%.
Вместе с переранжированием результатов сокращение достигло 67%.
Как работает дообучение
Дообучение продолжает тренировать готовую модель на сотнях или тысячах ваших примеров и меняет её веса. Оно хорошо учит формату, тону или узкой задаче, например раскладывать обращения по вашим категориям. А вот хранить факты так плохо: модель всё равно может их перепутать, источник ответа не виден, и каждое обновление означает новое обучение.
Когда не нужно ни то ни другое
В той же публикации Anthropic писала, что базу знаний меньше 200 тыс. токенов, около 500 страниц, можно целиком вставить в промпт, и тогда RAG вообще не нужен.
Сейчас её модели принимают миллион токенов, как и GPT-6.2 и Gemini 4, так что потолок стал выше. Сначала просто вставьте документы и посмотрите, устраивают ли вас ответы.
Мнение редакции
Редактор Intokened Макс говорит, что труднее всего ему было понять термин LLM. RAG понять проще, если представить его библиотекарем при LLM: он находит страницы, а модель их читает. Если ваша проблема в фактах, которые меняются, нужен поиск. Если в том, как выглядит ответ, дообучите модель. Эмбеддинги и другие термины по дороге объясняет наш глоссарий ИИ.
Данные о Contextual Retrieval взяты из собственных тестов Anthropic, опубликованных 19 сентября 2024 года. Размеры контекстного окна из документации компаний на 18 ноября 2026 года.
Автор
MaksТрейдер
Долгое время интересуюсь рынком криптовалют, являюсь трейдером, пишу статьи и новости о своем опыте простыми словами.
Комментарии (0)
Пока нет комментариев — будь первым!
Присоединяйся к нашему комьюнити
Без спама, можно отписаться в один клик
Похожие материалы
DeFi-токены в ноябре: Hyperliquid за год вырос на 66%, Ethena упал на 57%
Токенизированные акции на криптобиржах: что предлагают Kraken и OKX
Обёрнутый Monero XMR1 рухнул на 99%, взломщик продал токены на $13,5 млн
ПопулярноеТоп 7

Крипторынок теряет 4-5% за день: что говорят объёмы и трейдеры
76Рынок

